Europæiske universiteter befinder sig i et “nu eller aldrig”-øjeblik for computekraft. Forskningsgrupper ønsker større GPU-partitioner til modeltræning, mere forudsigelig MPI-ydeevne til simulering og strammere ekspeditionstider for delte, multi-tenant-klynger. Samtidig bliver budgetter gransket, energimålene bliver skarpere, og forventningerne til digital suverænitet er stigende.
I praksis fejler mange universiteters AI- og HPC-opgraderinger ikke på grund af CPU/GPU. De går i stå, fordi interconnecten ikke kan opretholde høj gennemstrømning under belastning uden uforudsigelige latency-spidser. Det er præcis det problemområde, Cornelis CN5000 er bygget til, og hvorfor det at kombinere Cornelis-teknologi med Hammers europæiske distributions- og leveringsmodel er en pragmatisk vej for universiteter, der har brug for ydeevne og operationel stabilitet.
Hvad ændrer sig, når et universitetscluster bliver “AI + HPC” i stor skala?
Universitetsmiljøer er unikt krævende, fordi de kombinerer:
• Tæt koblet HPC (MPI-kollektiver, latensfølsomhed, langvarige jobs)
• Distribueret AI-træning (båndbreddekrævende, kommunikationstunge mønstre som all-reduce)
• Multi-tenancy (mange brugere, mange jobformer, uforudsigelig samtidighed)
• Begrænsninger i delt infrastruktur (begrænset rackplads, strømgrænser, indkøbscyklusser)
I den blanding bliver interconnettet den “stille begrænser”. Overbelastningshændelser og langhale-latens sænker ikke kun en enkelt kørsel. De skævvrider retfærdigheden, spilder allokeringstimer og gør ydeevnen svær at stole på.
Cornelis CN5000 i klare vendinger: hvorfor det er anderledes
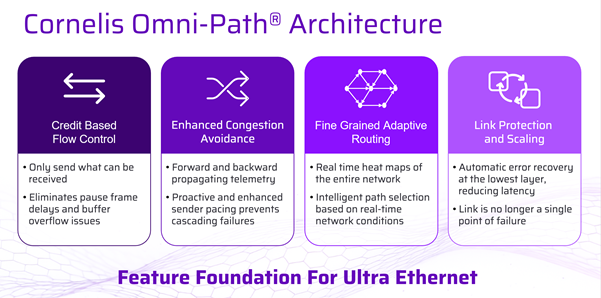
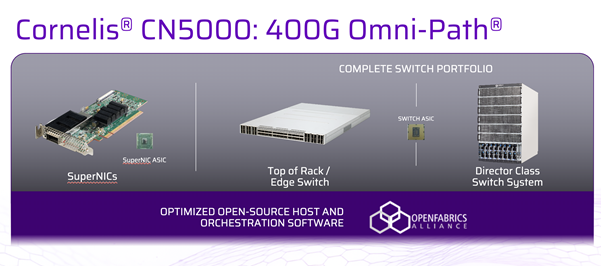
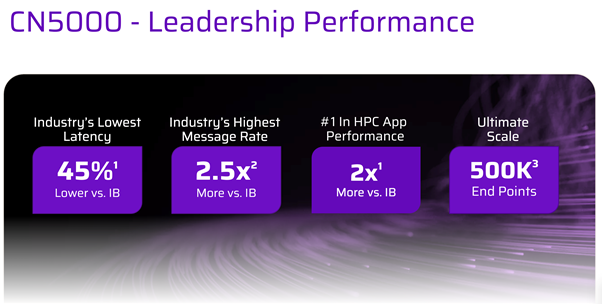
Cornelis CN5000 er en end-to-end HPC/AI-interconnectfamilie (switching, værtsgrænseflader, kabelføring og software) designet omkring et simpelt mål: hold gennemstrømningen høj og latensen stabil, når fabrikken er travl, hvilket er præcis den tilstand, de fleste universitetsklynger lever i.
Sammenligningstabel: CN5000 vs. almindelige universitetsinterconnect-muligheder
Tabellen nedenfor forbliver bevidst praktisk: den handler om operationel virkelighed i universitets-AI/HPC, ikke kun teoretiske topværdier.
|
Hvad universiteterne bekymrer sig om |
Cornelis CN5000 Omni-Path produktfamilie |
Ethernet (inkl. RoCE-varianter) |
InfiniBand |
|
Forudsigelig ydeevne under tung belastning |
Designet til at opretholde gennemstrømning med trængselsbevidst adfærd |
Kan være stærk, men kræver ofte omhyggelig tuning (PFC/ECN/QoS) for at undgå tab/latensspidser |
Typisk stærk til HPC/AI, men afhænger af fabric-design og driftsmodenhed |
|
Latensfølsomhed (MPI-kollektiver, tæt koblede jobs) |
Bygget til lav-latens skalerbar udvidelse med HPC i tankerne |
Normalt højere/ujævnere latenstid, medmindre det er konstrueret aggressivt |
Generelt fremragende latency-egenskaber til HPC-mønstre |
|
Multi-tenant-fairness (blandede jobstørrelser, mange brugere) |
Fokus på at reducere trængselsdrevet variabilitet |
Kan være udfordrende uden disciplineret QoS og løbende politikstyring |
Stærk, selvom partitionering og politik stadig betyder noget i stor skala |
|
Operationel kompleksitet |
Formålsbygget værktøj/telemetri til fabricen |
Kendt kompetencebase, men “lossless Ethernet” kan hurtigt blive kompliceret |
Specialistkompetencer; modne værktøjer, men kan være mere nichet |
|
Omkostningsforudsigelighed (end-to-end-fabric) |
Enkeltleverandør-netværksstack kan forenkle BOM og support |
Bredt leverandørvalg; omkostningerne varierer meget efter design (optik, switches, tuningindsats) |
Ofte premium; økosystemet er modent, men kan være dyrere pr. port |
|
Bedst egnet på universiteter |
AI + HPC, hvor præstationskonsistens betyder noget, og overbelastning er fjenden |
Blandede virksomheds- + forskningsmiljøer, der værdsætter standardisering og eksisterende Ethernet-færdigheder |
HPC-tunge websteder og nationale centre, hvor IB allerede er normen |
Sådan bruger du denne tabel: Hvis dit cluster hovedsageligt består af små, pinligt parallelle arbejdsbelastninger, betyder fabric mindre. Men hvis du laver distribueret træning, MPI-tung simulering, eller du kæmper med “gode dage og dårlige dage” ydeevne, bliver valget af interconnect en førsteprioritets designbeslutning.
Hvor CN5000 hjælper mest i universitets AI- og HPC-klynger
Hurtigere træning handler ikke kun om “flere GPU’er”, men om at holde GPU’erne fodret
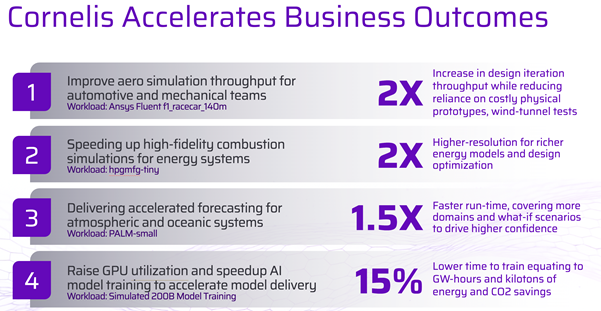
Distribueret træning kan blive kommunikationsbegrænset, når du skalerer op. Når netværket opfører sig inkonsekvent under belastning, ser du udnyttelsesfald, synkroniseringsstop og hakkende trin-tider. Et fabric designet til at forblive stabilt under samtidighed hjælper træningskørsler med at blive færdige hurtigere og med færre mærkelige “hvorfor var den kørsel langsommere?”-mysterier.
Forudsigelige HPC-kørsler i en multi-tenant scheduler
Universiteter bekymrer sig om tail latency, fordi én langsom rank kan trække hele et MPI-job ned. Et kongestionsresistent netværk reducerer disse langhalede adfærdsmønstre og gør ydeevnen mere reproducerbar i travle perioder (den reelle test, ærligt talt).
Skalering uden “kabelkaos”
Når klynger vokser, kan topologi- og kabelstrategi gøre eller bryde driften. Planlægning for udvidelse, portdensitet, lagdeling og fornuftige stier til at tilføje racks hjælper dig med at undgå en midtvejs-refaktorering, som ingen har tid til.
Hvorfor “Cornelis og Hammer” er en nyttig kombination i Europa
For europæiske universiteter er udfordringen ikke kun at vælge det rigtige netværk. Det handler også om indkøb, integration, opsætning og support på tværs af indkøbsrammer, partnerøkosystemer og stramme ændringsvinduer.
Hammers rolle i kanalen er værdifuld, fordi den kan hjælpe universiteter og integratorer med:
• Praktisk tilgængelighed og indkøb på tværs af EMEA-indkøbsruter
• Koordinering fra design til levering (at få den rigtige blanding af switching, host-forbindelser og kabelføring fra dag ét)
• Livscykluspragmatisme (strategi for reservedele, fasede udvidelser og at holde netværket konsistent over tid)
Kort sagt: Cornelis leverer det specialbyggede netværk; Hammer hjælper med at få det til at lande problemfrit i den europæiske universitetsvirkelighed.
Migreringsstrategi for universiteter, der flytter væk fra ældre netværk
De fleste universiteter bygger ikke “greenfield”-klynger. Du migrerer typisk fra noget som ældre Ethernet, ældre IB-generationer eller en blanding, der er vokset organisk.
En lavrisiko-migreringstilgang ser typisk sådan ud:
- Start med en dedikeret CN5000-pod
Byg en afgrænset partition (ofte GPU-først) med sit eget leaf/spine-design (eller tilsvarende). Dette lader dig validere ydeevnen uden at forstyrre den eksisterende infrastruktur. - Brug planlæggeren til at styre brugeroplevelsen
Opret klare partitioner/køer, så forskningsgrupper kan vælge det nye netværk, og standardiser derefter jobskabeloner og kommunikationsbiblioteker for gentagelighed. - Udvid efter arbejdsbyrde, ikke politik
Flyt de mest kommunikationstunge arbejdsbelastninger først: distribueret træning, MPI-tung simulering, storstilet analyse. Disse giver hurtigt målbare resultater. - Planlæg lagringsstien eksplicit
Lad ikke lagringsnetværket blive en eftertanke. Beslut tidligt, om lagringstrafikken er separat eller konvergeret, og design for forudsigelig konkurrenceadfærd. - Operationaliser telemetri og runbooks
Selv den bedste interconnect i verden kræver stadig day-2-disciplin: basismålinger, overbelastningsalarmer og en klar eskaleringsvej, når ydeevnen ændrer sig.
Denne trinvise metode har en tendens til at holde forskerne produktive, mens platformen udvikler sig under dem.
Europæiske overvejelser om indkøb, bæredygtighed og suverænitet
Europæiske universiteter skal ofte balancere ydeevne med begrænsninger, der ikke fremgår af et specifikationsblad:
• Mål for energieffektivitet og CO2-rapportering
Hvis du sporer energi pr. job eller pr. forskningsresultat, betyder konsistent ydeevne noget, fordi spildt tid er spildt strøm. Et mere jævnt netværk kan reducere “compute-churn” forårsaget af standsninger og gentagne forsøg.
• Suverænitet og dataplacering
Mange projekter er nu optaget af, hvor træning finder sted, hvor datasæt ligger, og hvem der kan supportere infrastrukturen. At vælge en løsning med stærk europæisk kanaldækning og supportveje kan forenkle governance.
• Rammer, tilskud og faseopdelt finansiering
Cluster-opgraderinger er ofte knyttet til tilskudsmilepæle. At designe et interconnect, der skalerer rent, uden en fuld redesign hver gang finansiering lander, holder køreplanen realistisk.
Det er her, Cornelis + Hammer-kombinationen er praktisk: den understøtter en europæisk leveringsmodel, mens den tekniske kerne forbliver fokuseret på AI/HPC-resultater.
Referencearkitekturmønstre for europæiske universiteter, der bruger CN5000
Mønster A: “AI-partition + klassisk HPC-partition” på et delt netværk
• AI-partition: GPU-noder (træning + finjustering), tunge kollektive kommunikationer
• HPC-partition: CPU- og acceleratornoder til simulering/analyse
• Mål: isoler støjende naboer på scheduler/QoS-niveau, mens du drager fordel af et skalerbart netværk
Mønster B: Afdelingspods, der senere forenes
Start med mindre pods, og udvid derefter, når bevillinger ankommer. Hold topologien konsistent, dokumentér kablingsstandarder, og undgå “engangs”-undtagelser, der bliver permanente problemer.
Mønster C: Tæt kerne til delte tjenester og samarbejder
Hvis dit universitet er en del af regionale eller nationale samarbejder, kan en tilgang med højere densitet i kernen reducere lag og forenkle driften, efterhånden som infrastrukturen vokser.
FAQ: CN5000 på travle universitetsklynger (poleret + strammet)
Hvordan forbedrer Cornelis CN5000 ydelseskonsistensen på travle universitetsklynger?
CN5000 er positioneret som en end-to-end-forbindelse designet til at holde gennemstrømningen høj og latensen stabil, når fabricen er travl, hvilket er præcis, når multi-tenant-universitetsklynger kæmper. I praksis betyder det noget, fordi overbelastning og langhale-latens kan skabe “gode dage og dårlige dage”-ydelse. En overbelastningsbevidst fabric hjælper med at reducere jitter, forbedrer repeterbarhed og gør det lettere at stole på fair planlægningsresultater.
Hvornår bliver netværksforbindelsen flaskehalsen for AI-træning og HPC?
Det bliver typisk en førsteprioritetsbegrænsning, når du skalerer ud over små, pinligt parallelle arbejdsbelastninger. Distribueret træning kan blive kommunikationsbegrænset, når du tilføjer flere GPU'er, og tæt koblede MPI-job kan trækkes ned af en enkelt langsom rang. I multi-tenant-miljøer kan uforudsigelig samtidighed udløse overbelastningshændelser, der spilder allokeringstimer og skævvrider retfærdigheden på tværs af brugere.
Er Cornelis CN5000 Ethernet eller InfiniBand, og gør den forskel?
Artiklen placerer CN5000 i Omni-Path-familien frem for at positionere den som Ethernet eller InfiniBand. For de fleste universitetsteams er det mere relevante spørgsmål, om strukturen leverer forudsigelig ydeevne under reel multi-tenant-belastning. Hvis dit problem er variabilitet under overbelastning, betyder “etiketten” mindre end, hvor stabile latenstid og gennemstrømning forbliver, når klyngen er travl.
Hvad er de vigtigste forskelle mellem CN5000, Ethernet/RoCE og InfiniBand for universiteter?
De beskrevne praktiske afvejninger handler om operationel virkelighed. CN5000 præsenteres som designet til forudsigelig ydeevne under tung belastning med kongestionsbevidst adfærd og specialbygget telemetri. Ethernet kan være velkendt, men “tabfri Ethernet” kræver ofte omhyggelig tuning for at undgå tab og latensspidser. InfiniBand er typisk stærkt til HPC/AI, men valg af fabric-design og modenhed i specialiseret drift betyder stadig noget i stor skala.
Hvordan kan CN5000 hjælpe med effektiviteten af distribueret AI-træning ud over “at tilføje flere GPU'er”?
Artiklens kernebudskab er, at hurtigere træning ofte kommer fra at holde GPU’erne konstant forsynet, ikke kun ved at øge antallet af GPU’er. Når netværk opfører sig inkonsekvent under belastning, kan man se synkroniseringsstop, udnyttelsesfald og ujævne trin-tider. Et fabric designet til at forblive stabilt under samtidighed reducerer disse stop, så træningen afsluttes hurtigere, og ydeevnen er mindre uforudsigelig fra kørsel til kørsel.
Hvad er en lavrisiko-migreringsplan for at flytte væk fra ældre Ethernet eller ældre interconnect-løsninger?
En trinvis tilgang er skitseret. Start med en dedikeret CN5000-pod, ofte GPU-først, for at validere ydeevnen uden at forstyrre den eksisterende infrastruktur. Brug planlæggeren til at oprette klare partitioner og køer, så teams kan vælge at deltage og standardisere jobskabeloner og kommunikationsbiblioteker. Udvid derefter efter arbejdsbyrde: flyt kommunikationstung distribueret træning og MPI-tung simulering først, mens du operationaliserer telemetri og runbooks.
Hvordan bør universiteter tænke om topologi og kabling, når klynger skaleres?
Artiklen argumenterer for, at skaleringsproblemer ofte viser sig som “kabelkaos” og refaktorering midt i levetiden. Planlægning for udvidelse, herunder porttæthed, lagdeling og hvordan nye racks tilsluttes fabric'en, hjælper med at holde driften fornuftig. Referencemønstre inkluderer at starte med mindre afdelings-pods, der senere forenes, at holde topologien konsistent og at dokumentere kabelstandarder for at undgå engangsundtagelser, der bliver permanente smertepunkter.
Hvorfor skal lagernettet planlægges sammen med interconnettet?
Lagring fremhæves som noget, der ikke bør være en eftertanke under migrering eller udvidelse. Du har brug for en eksplicit beslutning om, hvorvidt lagertrafik er separat eller konvergeret, og et design, der undgår uforudsigelig konkurrence. Uden det kan du ende med “mystiske opbremsninger”, der ligner compute-problemer, men som i virkeligheden er konkurrence på lagringsstien under delt belastning.
Hvordan påvirker bæredygtigheds- og suverænitetskrav valget af interconnect i Europa?
Artiklen fremhæver, at europæiske universiteter ofte har energimål, kulstofrapportering og forvaltningsforventninger omkring dataplacering og supportveje. Konsistent ydeevne betyder noget, fordi spildt tid er spildt strøm, især når standsninger og gentagne forsøg skaber beregningsmæssig omsætning. En skalerbar løsning, der vokser rent med trinvis finansiering og en europæisk leveringsmodel, kan også forenkle indkøbsrammer og langsigtet forvaltning.
Vil du vide mere?