Europas fysik- og life science-miljøer bevæger sig ind i en ny æra af ekstrem skala-computing: exascale-klassesystemer, trillion-parameter AI, datatørstige instrumenter og arbejdsgange, der blander simulering, analyse og AI i samme job. Her er den hårde sandhed, som de fleste kun indrømmer efter en brutal første skalatest: netværket er flaskehalsen, ikke GPU'erne, ikke lagringen, ikke engang CPU'en.
Det er her, Cornelis CN5000 Omni-Path® og Hammer’s HPC-løsningsdesign og -levering passer sammen: et netværk, der er konstrueret til at forblive forudsigeligt under tung belastning, kombineret med en tilgang, der hjælper europæiske organisationer med at designe, validere, implementere og understøtte den arkitektur, der matcher deres applikationer.
Hvad har ændret sig i europæisk forskningscomputing, og hvorfor netværksstrukturen betyder mere end nogensinde
Fysik og life science rammer begge lignende trykpunkter:
- Store MPI-kollektiver (allreduce/alltoall), følsomme over for tail-latens
- Mange små beskeder, hvor beskedhastigheden betyder lige så meget som båndbredden
- Incast- og bursty trafik (almindeligt i AI-træning, rekonstruktion og analyse-shuffles)
- Synkroniseringstung simulering, hvor jitter bliver til spildt beregningstid
Når et interconnect bliver overbelastet eller introducerer langhalede forsinkelser, ser du udnyttelsen kollapse - dyre acceleratorer sidder inaktive og venter på den næste batch eller kollektiv operation.
CN5000 i klare vendinger: hvad det er, og hvad det er designet til at løse
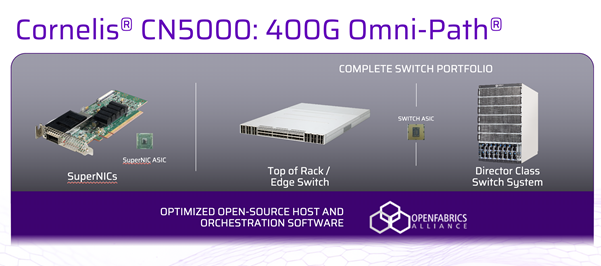
Cornelis CN5000 Omni-Path er en skalerbar netværksplatform rettet mod AI- og HPC-miljøer, hvor der kræves høj gennemstrømning og stabil ydeevne, selv når systemet er belastet.
Et par praktiske punkter, der betyder noget for HPC-teams:
- 400G pr. port switching (CN5000-switches refereres almindeligvis til som 48-port 400G-klasse, hvilket leverer meget høj samlet båndbredde pr. switch)
- Meget høj pakkebehandlingskapacitet (kritisk for HPC-trafik med små beskeder)
- Et designfokus på at undgå præstationsfald gennem tabsfri adfærd, styring af fabric-overbelastning, multipath-routing og robust flowkontrol
Kerneideen: hold kommunikationen forudsigelig, når klyngen er fuld af rigtige opgaver, ikke kun når man kører idealiserede tests på et stille netværk.
Hvor Hammer passer ind i at forvandle CN5000-kapacitet til en implementerbar europæisk løsning
CN5000 er fabric-teknologien. Hammers værdi er at få det til at fungere i den virkelige verden - ved at balancere præstationsmål med indkøbsbegrænsninger, tidsplaner, webstedsstandarder og operationel beredskab.
I praksis betyder det normalt:
- Oversættelse af applikationsbehov (MPI, AI-træning, pipeline-analyser) til et skalerbart fabric-design
- -Validering af ydeevne med de rigtige tests (ikke kun leverandørstandard-benchmarks
- Levering af en integreret løsning:
- Skiftning
- Kabling
- Værtsforbindelse
- Konfiguration
- Rollout-support
- Hjælpe teams med at operationalisere:
- Overvågning
- Ændringsstyring
- Reservedelsstrategi
- Supportmønstre for dag to
Sammenligningstabel: CN5000 vs almindelige HPC/AI-interconnect-tilgange
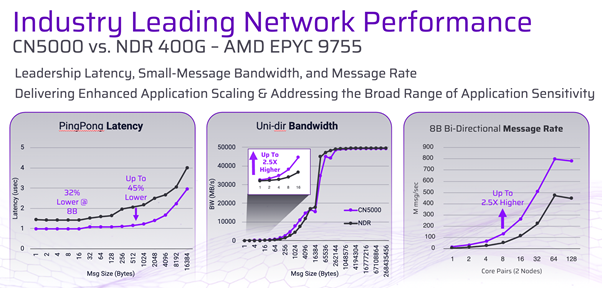
Det “bedste” interconnect afhænger af arbejdsbelastning, skala og operationelle præferencer. Tabellen nedenfor er en praktisk, arkitektur-niveau sammenligning, du kan bruge i design-diskussioner i den tidlige fase.
|
Kriterium |
Cornelis CN5000 Omni-Path |
InfiniBand (moderne generationer) |
Ethernet (RoCE / højtydende Ethernet) |
|
Primært designmål |
AI + HPC-skalaudvidelse med forudsigelige færdiggørelsestider under belastning |
HPC/AI-skalaudvidelse, bredt anvendt i top-end HPC |
Bredt datacenter + AI/HPC, hvor standardtilpasning og fælles værktøjer er nøglen |
|
Behaviour under congestion |
Designet til at minimere overbelastningspåvirkning og holde ydeevnen stabil (lossless fabric hensigt) |
Stærke muligheder afhængigt af konfiguration og overbelastningskontrol |
Kan være fremragende, men har tendens til at være mere følsom over for korrekt tuning (PFC/ECN, buffering, QoS) |
|
Tail-latensfølsomhed |
Generelt optimeret til lav latenstid og meddelelseshastighed |
Generelt meget stærk til lav latenstid og kollektiver |
Kan være konkurrencedygtig, men tail latency kan forringes, hvis den er fejlkonfigureret eller oversubscribed |
|
Operationel kompleksitet |
HPC-fokuseret værktøj og model; typisk mere “fabric-first” |
Modent økosystem; stærke operationelle mønstre i HPC |
Kendt for netværksteams, men “HPC-grade RoCE” kræver normalt omhyggelig designdisciplin |
|
Økosystem og integration |
Bygget til HPC/AI-stakke; integration afhænger af platformvalg |
Meget bred HPC-økosystemsupport |
Bredeste leverandør-/værktøjsøkosystem overordnet set |
|
Typisk sweet spot |
Tætte kollektiver, message-rate-tunge HPC, blandede AI/HPC-klynger, hvor forudsigelighed er prioriteten |
Meget store HPC/AI-implementeringer med etablerede IB-praksisser |
Websteder, der standardiserer på Ethernet, blandede arbejdsbelastninger eller søger en samlet netværksdriftsmodel |
|
Almindelig risiko, hvis det vælges dårligt |
Underdimensioneret validering (ikke test af rigtige arbejdsbelastningsmønstre tidligt) |
Omkostnings-/tilgængelighedsplanlægning; designvalg betyder noget i stor skala |
“Det er Ethernet, det går nok”-tænkning, indtil PFC-storme, QoS-gab eller støjende naboer dukker op |
Hvis du vil have en tommelfingerregel: HPC og videnskabelig AI har ikke bare brug for hurtige forbindelser; de har brug for et netværk, der forbliver stabilt, når alle kommunikerer på samme tid.
En praktisk blueprint: implementering af CN5000 til europæisk fysik og life sciences
1) Start med kommunikationsprofilen (ikke portantal)
Stil spørgsmål som:
- Er vi kollektiv-dominerede (allreduce/alltoall)?
- Er vi message-rate begrænset (mange små beskeder)?
- Ser vi præstationsfald, når systemet er belastet?
- Venter GPU'er på synkronisering?
Dette afgør, om du bør optimere for båndbredde, latenstid, haleadfærd eller en afbalanceret tilgang.
2) Design til skaleringstrin, ikke et enkelt snapshot
Mange europæiske organisationer skalerer i faser:
- Pod- eller rack-skala proof of value
- Multi-rack produktion
- Multi-cluster eller fødereret vækst
Et CN5000-fabric-design bør afspejle dette fra dag ét, herunder topologi, kablingsstrategi, vækstporte og operationelle grænser.
3) Valider med rigtig videnskab Stop ikke ved mikrobenchmarks. Inkluder:
- MPI-kollektiver i tilsigtet skala
- Mini-apps og repræsentative kerner
- AI-træningskommunikationstests (kollektiv-tunge trin)
- Belastningstest med flere lejere, hvis du kører delt infrastruktur
Målet er at opdage “stille laboratoriegevinster” versus “produktionsrealitetsgevinster” tidligt, mens ændringer stadig er billige.4) Operationaliser tidligt (fordi dag-2 er, hvor projekter lykkes eller dør)
Planlæg for:
- Telemetri og dashboards (latens, overbelastningssignaler, linkfejl, hotspots)
- Ændringsstyring (firmware, konfigurationsdrift, kontrolleret udrulning)
- Reservedele og robusthedsplanlægning
Det er her, Hammers leverings- og supporttilgang kan lukke kløften mellem et hurtigt netværk og en håndterbar service.
Referencearkitekturmønstre for europæiske laboratorier og forskningsinstitutter
Her er tre almindelige mønstre, der fungerer godt, når man bygger omkring CN5000 til fysik- og life science-miljøer
Mønster A: “Science pod” til hurtig adoption
- 1–2 racks med compute (CPU eller GPU)
- Dedikeret CN5000 leaf-switching
- Klare indgangs-/udgangsgrænser til lagring og det bredere campusnetværk
- Ideel til at bevise reelle arbejdsbyrdegevinster og træne operations teams
Mønster B: Blandet AI + HPC produktionsklynge
- Adskil logiske partitioner eller køer for:
- AI-træning
- Simulering
- Datapipelines
- Fabric designet til at undgå påvirkninger fra støjende naboer under peak-træningskørsler
- Fokus på forudsigelige kollektiver og stabile jobafslutningstider
Mønster C: Vækst i flere klynger med delte tjenester
- Flere CN5000-baserede klynger (f.eks. life science-billeddannelse, fysiksimulering)
- Delte tjenester:
- Godkendelse
- Planlægningspolitik
- Overvågning
- Lagring
- Fabric-strategi fokuserer på gentagelighed: “Vi kan implementere dette igen med tillid.”
Der er ikke ét enkelt “korrekt” design-- det handler om, at du kan tilpasse topologien og driftsmodellen til, hvordan din organisation faktisk fungerer.
Datastyring, sikkerhed og samarbejde på tværs af Europa
Fysik og life science befinder sig ofte i hver sin ende af dataforvaltningsspektret – fra relativt åbne eksperimentelle data i nogle fysikdomæner til yderst følsomme menneskelige data i dele af life science. Moderne HPC-netværksdesign må anerkende denne virkelighed.
Når man implementerer CN5000-baseret infrastruktur i europæiske miljøer, er det vigtigt at indbygge
- Segmentering efter design (projekter, lejere, regulerede datasæt)
- Revisionssikker ændringskontrol (hvem ændrede hvad, hvornår og hvorfor)
- Klare grænser til lagring og eksterne netværk (minimer uventede datastier)
- Samarbejdsberedskab (support til fødererede adgangsmodeller, hvor det er relevant
Intet af dette er prangende, men det er ofte forskellen mellem ”en hurtig klynge” og ”en platform, organisationen kan stole på i de næste fem år”.
Almindelige use cases, hvor CN5000 + Hammer levering kan gøre en forskel
AI-træning til videnskabelige modeller
- Kollektiver, synkroniseringspunkter og burst-mønstre dominerer
- Forudsigelighed under belastning er det, der forbedrer tid-til-resultater
Storskala simulering med synkroniseringspunkter
- Hale-latens og jitter kan alvorligt påvirke tæt koblede fysiksimuleringer
- Meddelelseshastighedskapacitet og stabil adfærd betyder noget
Billeddannelse, rekonstruktion og multi-omics pipelines
- Workflows blander båndbreddetunge faser og kommunikationstunge shuffles
- Kører ofte samtidigt på tværs af flere teams
FAQ: Hvordan CN5000 Omni-Path hjælper i rigtige HPC + AI-klynger
Hvordan forbedrer Cornelis CN5000 Omni-Path HPC- og AI-ydeevne i rigtige klynger?
I produktionsklynger er gennemstrømning ofte ikke begrænsningen; det er overbelastning og langhale-latens. CN5000 er bygget til at holde kommunikationen forudsigelig under belastning, så jobs ikke rammer “performance-klipper”, når mange lejere eller mange rækker kommunikerer på én gang.
Praktisk set stammer det fra et Omni-Path-design, der lægger vægt på:
- Tabsfri adfærd med kreditbaseret flowkontrol (så du ikke falder i tab/genudsendelsesspiraler under pres).
- Finkornet adaptiv routing / multipath for at styre uden om forbigående hotspots.
- Aktiv overbelastningsstyring (ofte beskrevet som switch-informeret pacing/nedbremsning) for at reducere haleeffekter.
Nettovirkningen: færre standsninger i kollektiver og synkroniseringsfaser, og bedre acceleratorudnyttelse, når netværket er optaget.
Hvilke typer arbejdsbelastninger har størst gavn af CN5000 i fysik og life science?
CN5000 har en tendens til at vise sig bedst, når jitter og hale-latens dominerer resultaterne, især:
- Tætte MPI-kollektiver (f.eks. allreduce/alltoall) i stor skala
- Applikationer med høj meddelelsesrate og mange små meddelelser
- Synkroniseringstunge simuleringer, hvor få langsomme rækker trækker tidssteppet ned
- Bursty eller incast-tung trafik set i multi-node AI-træning, rekonstruktionspipeliner og shuffle-tung analyse
Hvis din profilering viser stigende tid brugt på kollektiver, barrierer eller halo-udvekslinger, når du skalerer ud, er dette den type problem, som CN5000 er designet til at løse.
Hvorfor bliver netværket flaskehalsen før GPU'er eller lagring i stor skala?
Når klynger skaleres, bruges mere væg-tid på koordinering (gradienter, reduktioner, udvekslinger, barrierer. Når overbelastning eller langhalede forsinkelser opstår, ender de hurtigste noder og GPU'er med at vente på de langsomste kommunikationshændelser. Udnyttelsen kan kollapse, selvom “peak-båndbredde” ser stærk ud på papiret.
Hvordan adskiller CN5000 sig fra InfiniBand eller højtydende Ethernet (RoCE)?
På et højt niveau:
- CN5000 (Omni-Path): Positioneret som et end-to-end scale-out-fabric, der er tunet til forudsigelig ydeevne under belastning, og som udnytter tabsfri adfærd, adaptiv routing og overbelastningskontrol som førsteklasses designmål.
- InfiniBand: bredt udbredt i top-end HPC med et dybt økosystem og modne operationelle praksisser (fremragende ydeevne, bred leverandørstøtte).
- RoCE / højtydende Ethernet: Operationelt velkendt og i stand til stærk ydeevne, men kræver typisk disciplin omkring PFC/ECN-design, buffering, QoS og kontrol af støjende naboer for at undgå overraskelser med hale-latens i stor skala.
Det er også værd at sige klart: CN5000’s “fulde fordele” beskrives typisk som kommende fra en end-to-end Omni-Path-løsning (switches + NIC’er) frem for at blande og matche i datastien.
Hvad leverer Hammer faktisk i et CN5000-baseret HPC-projekt?
Hammer turns the interconnect into something you can run day to day, typically covering:
- Krav → fabric-design: (topologi, oversubscription-mål, vækstplan, kabelstrategi)
- Validering: testplaner, der afspejler reelle arbejdsbelastninger (ikke kun stille laboratorie-mikrobenchmarks)
- Opbygning og udrulning: switche, optik/kabler, host-forbindelse, konfigurationsskabeloner, cutover-support
- Drift: forventninger til overvågning/telemetri, ændringsstyring, reservedelsstrategi og support-runbooks
Hvordan skal vi validere et CN5000-fabric, før vi forpligter os til fuld udrulning?
En praktisk validering før udrulning omfatter normalt:
- MPI-kollektive test i den tilsigtede skala (ikke kun enkelt-rack)
- Mini-apps / repræsentative kerner fra din faktiske brugerbase
- AI-kommunikationstests, der belaster kollektivtunge trin (og overlapningsmønstre)
- Stress-tests med blandede lejere for at afdække støjende nabo-effekter og langhale-adfærd
Målet: at fange tilfælde, hvor "stille laboratorie-sejre" ikke oversættes til produktion—mens topologi- og politikændringer stadig er billige.
Hvordan designer vi et CN5000-netværk til faset vækst på tværs af europæiske forskningssteder?
Mange programmer skalerer i faser (pod → multi-rack → multi-cluster/federation). Almindelige designvalg, der holder væksten smertefri:
- Vælg en topologi med en klar udvidelsesvej (porte reserveret til vækst, forudsigelig kabling)
- Definér operationelle grænser tidligt (lejere/partitioner/køer, QoS-forventninger)
- Planlæg, hvordan du håndterer ændringsstyring og “blast radius”, når du tilføjer racks eller lokationer
På den måde introducerer skalering ikke utilsigtet nye flaskehalse eller støjende nabo-adfærd
Hvordan kan CN5000-implementeringer understøtte dataforvaltning og sikkerhed i hele Europa?
I regulerede life science-miljøer er netværket en del af kontrolplanet for governance. Typiske mønstre inkluderer:
- Segmentering efter projekt/lejer (så regulerede datasæt ikke deler uventede stier)
- Revisionssikker konfiguration + ændringsstyring tilpasset din sikkerhedsmodel
- Klare grænser til lagring og eksterne netværk for at undgå utilsigtede dataudgangsruter
- Hvor samarbejde er nødvendigt, bevidste fødererede adgangsmønstre frem for ad-hoc-peering
Vigtigste pointer for europæiske forskningsledere
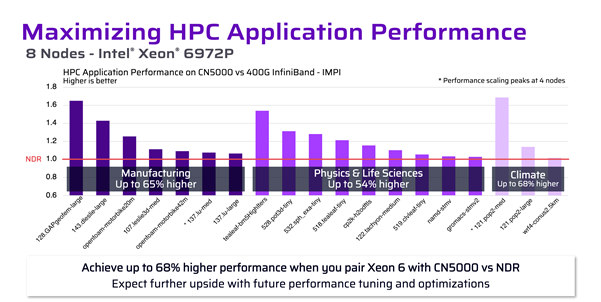
- Netværket er i stigende grad den afgørende faktor for reel ydeevne i fysik og life science, især med blandede AI + HPC-arbejdsbelastninger.
- Cornelis CN5000 sigter mod forudsigelig ydeevne i stor skala, hvor overbelastningsadfærd og hale-latens ofte dominerer jobafslutningstiden.
- Hammer hjælper med at omsætte denne kapacitet til en fungerende europæisk løsning:
- Designet
- Valideret
- Implementeret
Kan drives som en tjeneste– ikke blot en samling af højtydende komponenter. Kontakt vores eksperter i dag for at drøfte Cornelis Networks-løsninger
Vil du vide mere?